GPT-5.5 提示词实战指南
你花了3小时写了一份2000字的「超详细Prompt」,结果GPT-5.5给你的回答还不如以前?
问题可能不是模型变笨了,而是你的提示词太啰嗦了。
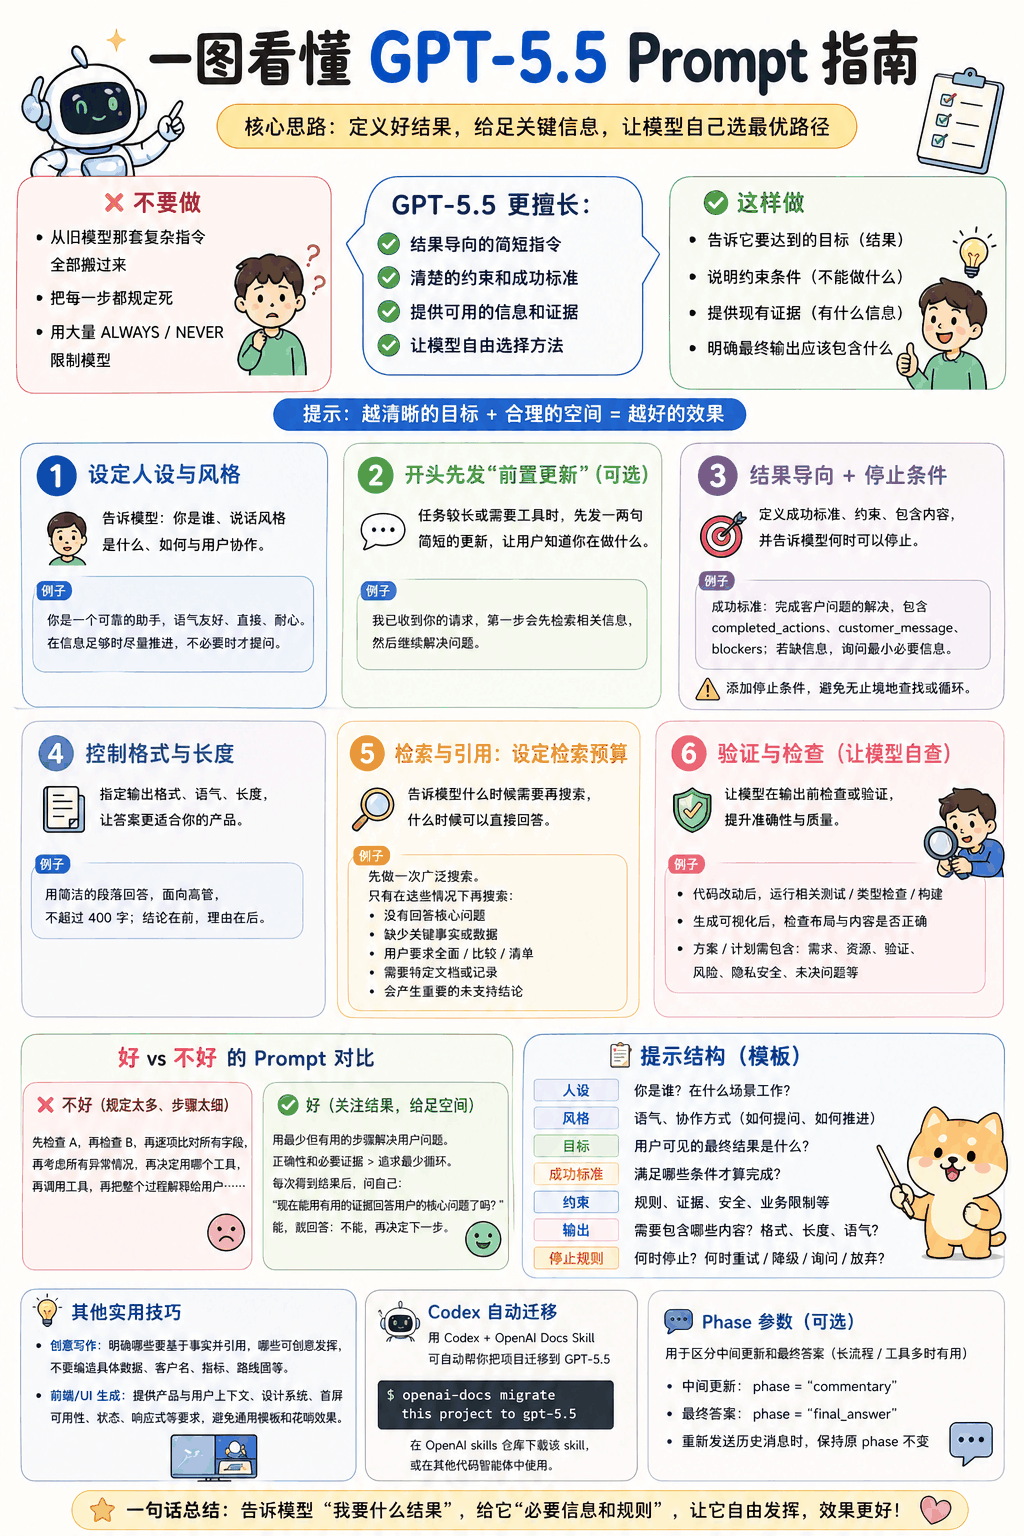
OpenAI刚发布的GPT-5.5 Prompt Guidance,说白了就一句话:别教它怎么做,告诉它做成什么样。
这篇指南我把官方文档嚼碎了喂给你,附带可以直接复制的Prompt模板。读完立刻上手,不需要你懂什么「思维链工程」。
一句话总结
| 旧习惯 | GPT-5.5的新做法 |
|---|---|
| 写10条步骤指令 | 写1条成功标准 |
| 用「必须」「永远」压模型 | 用停止条件告诉它「够了就停」 |
| 塞满背景上下文 | 给检索预算,让它自己决定搜多少 |
| 把人格和任务混一起写 | 分开写 Personality + Collaboration Style |
| 等它全部想完再输出 | 先发一句preamble,骗过用户等待焦虑 |
 |
|
| 说白了: GPT-5.5默认脾气就是高效、直接、不爱废话。你管得越细,它反而越笨。 |
第一章:结果导向 > 过程导向
以前我们写Prompt,生怕它漏掉什么,于是:
这种写法老模型可能还行,但对GPT-5.5来说,这叫噪音。
它会把模型逼到角落里,回答变得机械。GPT-5.5没那么笨,你直接告诉它好结果长什么样就行。
正确示范
看见没?没有步骤,只有标准。
这些词留给真正的安全红线就够了,比如「绝不能泄露用户隐私」。至于什么时候该搜、什么时候该问,交给模型自己决定。
第二章:人格要拆成两半写
GPT-5.5默认语气就是高效、直接、不废话。如果你做的是客服、教练、或者任何需要"人味"的产品,你得明确告诉它「你是什么人设」。
不过,人格不是一句「你要友好一点」就完事的。官方建议分成两块:
Personality( personality = 声音)
控制模型听起来怎样——温暖还是冷淡,正式还是随意,有没有幽默感。
Collaboration Style(collaboration = 行为)
控制模型怎么干活——什么时候追问,什么时候先假设,给多少上下文,怎么面对不确定性。
可直接复制的人格模板
任务型助手:
表达型助手:
人格定义写短一点就好。别妄想用 personality 来掩盖你任务目标写得糊里糊涂。
第三章:一句preamble,治好用户等待焦虑
用流式回复的时候,用户最烦的是什么?
白屏。
GPT-5.5遇到复杂任务时,会先自己在脑子里盘算、准备调工具,这时候用户啥也看不到。解决办法很简单:让它先说一句人话。
最小Demo
在你的Prompt最后加一句:
效果就像这样:
用户问:"帮我查一下过去三个月销售额,然后按地区分组做个图表。"
GPT-5.5第一句立刻回:"好的,我先从数据库调取过去三个月的销售记录。"(然后开始默默干活)
用户等的时间,从3秒变成了0.1秒。
第四章:停止条件比「继续」更重要
GPT-5.5有一个特点:只要你不喊停,它可能会一直"再搜一下"、"再验证一下"。
这时候你就得给它定个停止规则。
正确示范
以及缺证据时怎么办:
翻译成人话: 能用一次搜索回答的,别搜两次;能回答的,别继续翻资料;证据不够的,直接问用户要,别瞎编。
第五章:给模型一个「检索预算」
GPT-5.5很喜欢搜索。如果你不给它设预算,它能把你的API账单搜爆。
检索预算就是停止规则:告诉它什么时候搜够了。
可直接复制的检索预算模板
这句话最重要:别为了让回答更"漂亮"而重复搜索。能用现有结果回答的,立刻回答。
第六章:让模型自己检查自己的工作
以前我们写代码,自己跑一遍就交了。到了GPT-5.5这,你可以直接在Prompt里让它自己检查。
代码任务
视觉/UI任务
工程/规划任务
人话版: 别当GPT-5.5是写完就扔的实习生,把它当成会自己跑CI的工程师。
第七章:万能Prompt结构(直接复制)
官方给了一个万能模板,复杂Prompt直接套:
每条写短一点,别在不能改行为的地方堆字数。
总结
GPT-5.5的提示词,说到底就是从"教步骤"变成"定规则"。
你不需要告诉它第一步做什么、第二步做什么。说清楚这几点就够了:你是谁、怎么说话、怎么干活、好结果的标准、什么时候停、预算是多少。
然后让它自己去飞。
如果你还在用给GPT-4写的那套「超详细逐步指令」,试试今天这篇指南里的写法。你多半会发现:Prompt变短了,回答变好了。
你写过最长的Prompt有多少字?有没有遇到过"越详细越翻车"的情况?评论区聊聊。